


Как устроен Google Поиск: инженерный разбор от обхода до AI Overviews

12
Ноября
2026
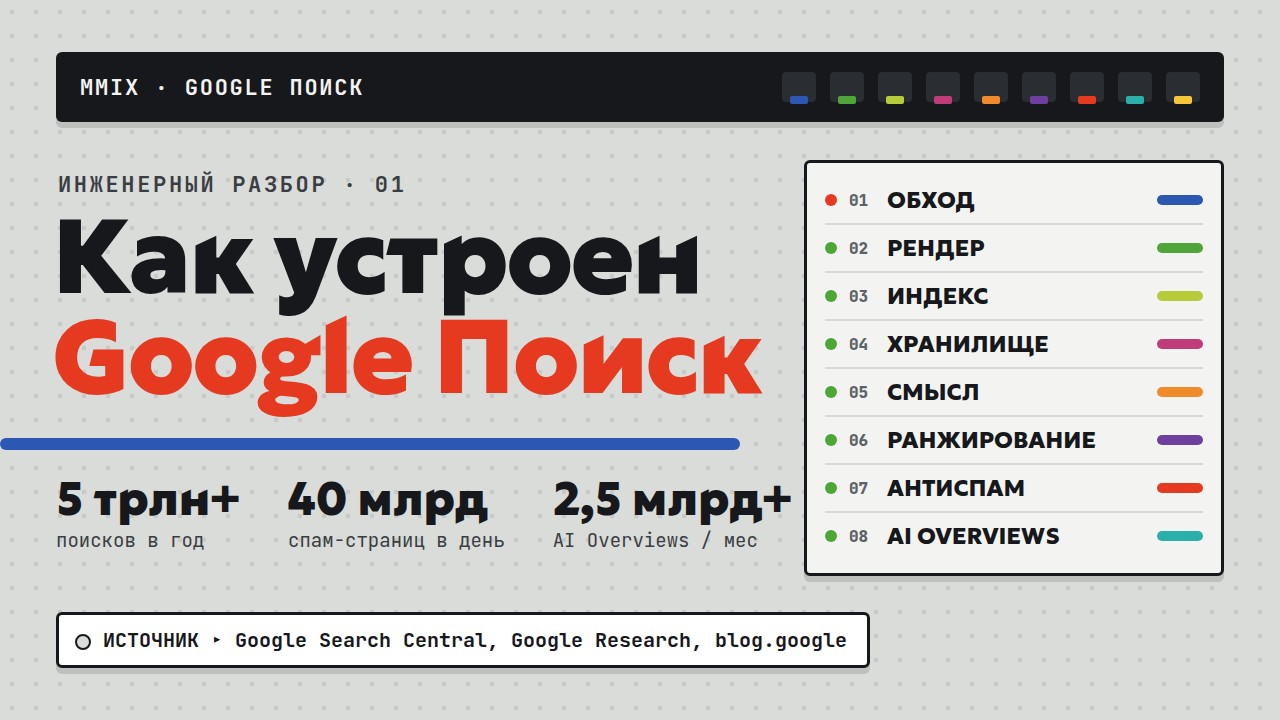
Google видит больше 5 триллионов поисков в год (blog.google, март 2025), и 15% запросов каждый день новые: их раньше никто не задавал (How Search Works). Ниже разбор того, что происходит между вашим сайтом и строкой выдачи: восемь шагов, у каждой цифры есть ссылка на документ Google. Это первая серия цикла MMIX «Как устроена платформа».
Коротко
- Поиск работает в три этапа: обход, индексирование, выдача. До конца доходят далеко не все страницы.
- Googlebot собирает страницу в headless Chromium и выполняет JavaScript. Контент, который появляется только после скриптов, должен пережить рендер.
- Индекс охватывает сотни миллиардов страниц и весит больше 100 млн ГБ.
- Ранжирование учитывает сотни факторов за долю секунды; PageRank до сих пор входит в базовые системы.
- Для AI Overviews отдельных требований нет: страница должна быть в индексе и подходить для показа со сниппетом.
Шаг 1. Обход: Googlebot идёт по ссылкам
Единого реестра всех страниц интернета нет. Google находит новые адреса по ссылкам с уже известных страниц и по картам сайта (sitemap.xml), этот процесс называется URL discovery (Search Central). Googlebot сам решает, какие сайты обходить, как часто и сколько страниц брать. На большинство сайтов он заходит в среднем не чаще раза в несколько секунд, и большую часть запросов делает мобильный краулер (документация Googlebot).
Карта сайта помогает найти адреса, при этом обход и индексацию она не гарантирует.
Шаг 2. Рендер: страницу собирает браузер без экрана
Страницы с кодом 200 попадают в очередь рендеринга. Там они ждут несколько секунд, иногда дольше. Когда ресурсы освобождаются, headless Chromium выполняет JavaScript, и Google работает уже с готовым HTML (JavaScript SEO basics). Без рендера Google может не увидеть часть контента (How Google Search works). Отсюда правило для сайтов на React, Vue и других фреймворках: важный текст и ссылки должны быть в HTML после рендера, а лучше сразу в ответе сервера.
Шаг 3. Индекс: указатель, как в конце книги
Индекс устроен как предметный указатель: для каждого слова на каждой проиндексированной странице есть запись. Он охватывает сотни миллиардов страниц и весит больше 100 000 000 гигабайт (Organizing information). Похожие страницы Google объединяет в кластер и выбирает одну каноническую. Попадание в индекс не гарантировано (Search Central).
Шаг 4. Хранилище: на чём строили индекс
Основу Google описал в научных статьях. GFS, распределённая файловая система (2003, статья SOSP). MapReduce (2004): на нём переписали боевую систему индексации веб-поиска (статья OSDI). Bigtable (2006): хранилище на тысячах серверов, им пользуется в том числе веб-индексация (статья OSDI). В 2010 году новый индекс Caffeine стал обновляться непрерывно небольшими порциями и дал выдачу на 50% свежее (Official Google Blog). Все эти цифры исторические: как индекс хранится сегодня, Google публично не раскрывает.
Шаг 5. Смысл запроса: нейросети
RankBrain в 2015 году стал первой системой глубокого обучения в Поиске. В 2018 году пришло нейронное сопоставление (neural matching), в 2019 году BERT. К 2022 году BERT участвует почти в каждом запросе на английском (blog.google, 2022). MUM (2021) обучен на 75 языках (blog.google), при этом для общего ранжирования он сейчас не используется (Ranking systems guide).
Шаг 6. Ранжирование: сотни факторов за долю секунды
Релевантность определяют сотни факторов, среди них язык, местоположение и устройство пользователя (Search Central). Системы ранжирования оценивают сотни миллиардов страниц за долю секунды. PageRank, описанный в статье основателей Google 1998 года (Brin & Page), сильно изменился с тех пор и по-прежнему входит в базовые системы (Ranking systems guide). Деньги за позицию Google не берёт: ранжирование программное.
Расхожая цифра «200+ факторов» в текущих документах Google не встречается, там написано «сотни факторов».
Шаг 7. Антиспам: 40 миллиардов страниц в день
Системы Google находят 40 миллиардов спамных страниц каждый день (Detecting spam). SpamBrain, ИИ-система против спама, работает с 2018 года и держит больше 99% поисков без спама (Webspam Report 2021).
Шаг 8. AI Overviews: ответ над ссылками
С 14 мая 2024 года AI Overviews начали показывать всем пользователям в США, их собирает модель Gemini, настроенная под Поиск (blog.google). В мае 2026 года AI Overviews видели больше 2,5 миллиарда пользователей в месяц, AI Mode за год перешёл отметку в 1 миллиард (Google I/O 2026). Для показа в AI Overviews и AI Mode дополнительных требований нет: страница должна быть в индексе и подходить для показа со сниппетом (AI features and your website).
Что это значит для вашего сайта
Минимальный чек-лист по документации Google
- Googlebot не заблокирован в robots.txt и на сервере (Search Essentials).
- Страница отдаёт HTTP 200 и содержит индексируемый контент.
- Текст и ссылки видны после рендера JavaScript.
- Контент написан для людей, системы ранжирования отдают приоритет полезной информации (Helpful content).
- Попасть в выдачу бесплатно: позицию купить нельзя.
MMIX делает сайты и ведёт SEO с 2012 года. Проверим, как Google обходит, рендерит и индексирует ваш сайт, и покажем, что мешает страницам попасть в выдачу.
Следующая серия цикла: как устроен Instagram.
Источники
- blog.google — AI, personalization and the future of shopping (03.03.2025)
- Google — How Search Works
- Google Search Central — In-depth guide to how Google Search works
- Google Search Central — Googlebot
- Google Search Central — Understand the JavaScript SEO basics
- Google — How Search Works: Organizing information
- Google Research — The Google File System (SOSP 2003)
- Google Research — MapReduce: Simplified Data Processing on Large Clusters (OSDI 2004)
- Google Research — Bigtable: A Distributed Storage System for Structured Data (OSDI 2006)
- Official Google Blog — Our new search index: Caffeine (08.06.2010)
- blog.google — How AI powers great search results (03.02.2022)
- blog.google — MUM: A new AI milestone for understanding information (18.05.2021)
- Google Search Central — A guide to Google Search ranking systems
- Brin & Page — The Anatomy of a Large-Scale Hypertextual Web Search Engine (1998)
- Google — How Search Works: Detecting spam
- Google Search Central Blog — Webspam Report 2021 (21.04.2022)
- blog.google — Generative AI in Search (14.05.2024)
- blog.google — Google I/O 2026: Sundar Pichai's opening keynote (19.05.2026)
- Google Search Central — AI features and your website
- Google Search Central — Search Essentials: technical requirements
- Google Search Central — Creating helpful, reliable, people-first content
Связаться с нами
И ответим на все интересующие Вас вопросы.
 DUNS Number: 68-606-2061
 NCAGE Number: A3G3J

 "INNOVA CONSULTING GROUP"


Комментарии
Написать комментарий