


Як працює Google Пошук: інженерний розбір від обходу до AI Overviews

12
Листопада
2026
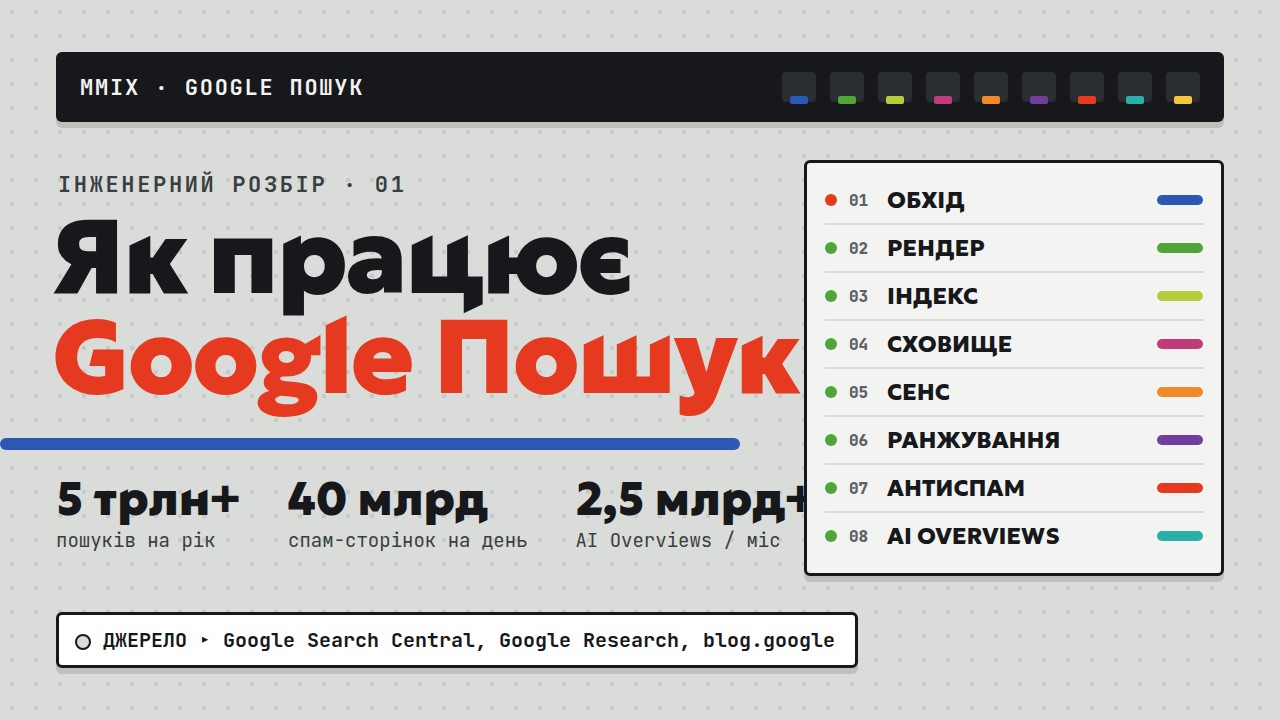
Google бачить понад 5 трильйонів пошуків на рік (blog.google, березень 2025), і 15% запитів щодня нові: їх раніше ніхто не ставив (How Search Works). Нижче розбір того, що відбувається між вашим сайтом і рядком видачі: вісім кроків, у кожної цифри є посилання на документ Google. Це перша серія циклу MMIX «Як працює платформа».
Коротко
- Пошук працює у три етапи: обхід, індексування, видача. До кінця доходять далеко не всі сторінки.
- Googlebot збирає сторінку в headless Chromium і виконує JavaScript. Контент, що з'являється лише після скриптів, має пережити рендер.
- Індекс охоплює сотні мільярдів сторінок і важить понад 100 млн ГБ.
- Ранжування враховує сотні факторів за частку секунди; PageRank досі входить до базових систем.
- Для AI Overviews окремих вимог немає: сторінка має бути в індексі й підходити для показу зі сніпетом.
Крок 1. Обхід: Googlebot іде посиланнями
Єдиного реєстру всіх сторінок інтернету немає. Google знаходить нові адреси за посиланнями з уже відомих сторінок і за картами сайту (sitemap.xml), цей процес називається URL discovery (Search Central). Googlebot сам вирішує, які сайти обходити, як часто і скільки сторінок брати. На більшість сайтів він заходить у середньому не частіше ніж раз на кілька секунд, і більшість запитів робить мобільний краулер (документація Googlebot).
Карта сайту допомагає знайти адреси, проте обхід та індексацію вона не гарантує.
Крок 2. Рендер: сторінку збирає браузер без екрана
Сторінки з кодом 200 потрапляють у чергу рендерингу. Там вони чекають кілька секунд, інколи довше. Коли ресурси звільняються, headless Chromium виконує JavaScript, і Google працює вже з готовим HTML (JavaScript SEO basics). Без рендеру Google може не побачити частину контенту (How Google Search works). Звідси правило для сайтів на React, Vue та інших фреймворках: важливий текст і посилання мають бути в HTML після рендеру, а краще одразу у відповіді сервера.
Крок 3. Індекс: покажчик, як у кінці книги
Індекс влаштований як предметний покажчик: для кожного слова на кожній проіндексованій сторінці є запис. Він охоплює сотні мільярдів сторінок і важить понад 100 000 000 гігабайт (Organizing information). Схожі сторінки Google об'єднує в кластер і обирає одну канонічну. Потрапляння в індекс не гарантоване (Search Central).
Крок 4. Сховище: на чому будували індекс
Основу Google описав у наукових статтях. GFS, розподілена файлова система (2003, стаття SOSP). MapReduce (2004): на ньому переписали бойову систему індексації вебпошуку (стаття OSDI). Bigtable (2006): сховище на тисячах серверів, ним користується зокрема вебіндексація (стаття OSDI). У 2010 році новий індекс Caffeine почав оновлюватися безперервно невеликими порціями і дав видачу на 50% свіжішу (Official Google Blog). Усі ці цифри історичні: як індекс зберігається сьогодні, Google публічно не розкриває.
Крок 5. Сенс запиту: нейромережі
RankBrain у 2015 році став першою системою глибокого навчання в Пошуку. У 2018 році з'явилося нейронне зіставлення (neural matching), у 2019 році BERT. До 2022 року BERT бере участь майже в кожному запиті англійською (blog.google, 2022). MUM (2021) навчений на 75 мовах (blog.google), проте для загального ранжування він зараз не використовується (Ranking systems guide).
Крок 6. Ранжування: сотні факторів за частку секунди
Релевантність визначають сотні факторів, серед них мова, місцезнаходження та пристрій користувача (Search Central). Системи ранжування оцінюють сотні мільярдів сторінок за частку секунди. PageRank, описаний у статті засновників Google 1998 року (Brin & Page), відтоді сильно змінився і досі входить до базових систем (Ranking systems guide). Гроші за позицію Google не бере: ранжування програмне.
Поширеної цифри «200+ факторів» у чинних документах Google немає, там написано «сотні факторів».
Крок 7. Антиспам: 40 мільярдів сторінок на день
Системи Google знаходять 40 мільярдів спамних сторінок щодня (Detecting spam). SpamBrain, ШІ-система проти спаму, працює з 2018 року і тримає понад 99% пошуків без спаму (Webspam Report 2021).
Крок 8. AI Overviews: відповідь над посиланнями
З 14 травня 2024 року AI Overviews почали показувати всім користувачам у США, їх збирає модель Gemini, налаштована під Пошук (blog.google). У травні 2026 року AI Overviews бачили понад 2,5 мільярда користувачів на місяць, AI Mode за рік перейшов позначку в 1 мільярд (Google I/O 2026). Для показу в AI Overviews і AI Mode додаткових вимог немає: сторінка має бути в індексі й підходити для показу зі сніпетом (AI features and your website).
Що це означає для вашого сайту
Мінімальний чек-лист за документацією Google
- Googlebot не заблокований у robots.txt і на сервері (Search Essentials).
- Сторінка віддає HTTP 200 і містить контент, придатний для індексації.
- Текст і посилання видно після рендеру JavaScript.
- Контент написаний для людей, системи ранжування віддають пріоритет корисній інформації (Helpful content).
- Потрапити у видачу безкоштовно: позицію купити неможливо.
MMIX робить сайти й веде SEO з 2012 року. Перевіримо, як Google обходить, рендерить та індексує ваш сайт, і покажемо, що заважає сторінкам потрапити у видачу.
Наступна серія циклу: як працює Instagram.
Джерела
- blog.google — AI, personalization and the future of shopping (03.03.2025)
- Google — How Search Works
- Google Search Central — In-depth guide to how Google Search works
- Google Search Central — Googlebot
- Google Search Central — Understand the JavaScript SEO basics
- Google — How Search Works: Organizing information
- Google Research — The Google File System (SOSP 2003)
- Google Research — MapReduce: Simplified Data Processing on Large Clusters (OSDI 2004)
- Google Research — Bigtable: A Distributed Storage System for Structured Data (OSDI 2006)
- Official Google Blog — Our new search index: Caffeine (08.06.2010)
- blog.google — How AI powers great search results (03.02.2022)
- blog.google — MUM: A new AI milestone for understanding information (18.05.2021)
- Google Search Central — A guide to Google Search ranking systems
- Brin & Page — The Anatomy of a Large-Scale Hypertextual Web Search Engine (1998)
- Google — How Search Works: Detecting spam
- Google Search Central Blog — Webspam Report 2021 (21.04.2022)
- blog.google — Generative AI in Search (14.05.2024)
- blog.google — Google I/O 2026: Sundar Pichai's opening keynote (19.05.2026)
- Google Search Central — AI features and your website
- Google Search Central — Search Essentials: technical requirements
- Google Search Central — Creating helpful, reliable, people-first content
Зв'язатися з нами
І відповімо на всі ваші запитання.
 DUNS Number: 68-606-2061
 NCAGE Number: A3G3J

 "INNOVA CONSULTING GROUP"
Коментарі
Write comment